Enterprise RAG-architectuur: Hoe je LLMs veilig koppelt aan je legacy CRM
04 Sep 2026
by Guido van Beek, CTO & Co-founder
Editor, Nadiy, Senior Content Writer
04 Sep 2026
by Guido van Beek, CTO & Co-founder
Editor, Nadiy, Senior Content Writer
Enterprise RAG-architectuur: Hoe je LLMs veilig koppelt aan je legacy CRM
Inhoudsopgave
Waar RAG echt voor bedoeld is
Waarom de live data van je CRM niet in een Vector Index thuishoort
Een praktijkvoorbeeld: Hoe dit er correct gesplitst uitziet
Waar "Legacy" het moeilijker maakt, en waar het echte risico ligt
Wat "Secure" hier daadwerkelijk moet betekenen
De andere angst en de andere garantie
Klaar om je visie om te zetten in custom software?
Neem contact op
We reageren binnen 48 uur.
Het integreren van LLMs met legacy CRM-systemen vereist een duidelijke scheiding van datatypen, in plaats van de hele database te behandelen als een retrieval-probleem. Hoewel vector search ideaal is voor ongestructureerde tekst zoals call notes en support tickets, introduceert het vertrouwen op vector-indices voor live, gestructureerde CRM-velden verouderde data, onnauwkeurige snapshots en aanzienlijke security-risico's. Het exporteren van volledige database-records naar externe vector stores omzeilt native access controls en creëert kwetsbare kopieën van gevoelige klantgegevens. In plaats daarvan moeten enterprise-architecturen live, gerichte API-connectors voor deterministische record-lookups combineren met selectieve semantische retrieval voor ongestructureerde content. Door data in het originele bronsysteem te behouden en zero-retention vendor-overeenkomsten of strategische self-hosting af te dwingen, kunnen organisaties veilig gebruikmaken van generatieve AI zonder de data-integriteit of bedrijfsbeveiliging in gevaar te brengen.
Belangrijkste Takeaways
- Ontkoppel gestructureerde data van Vector Search: Gebruik live, deterministische lookups voor exacte sleutelgegevens (bijv. accountstatus, dossiernummers) en bewaar RAG specifiek voor ongestructureerde content zoals support notes en SOPs.
- Voorkom dat data in de Vector Store veroudert: Vector-indices werken als statische snapshots; het indexeren van live CRM-velden riskeert het tonen van verouderde informatie aan agents tijdens tijdgevoelige workflows.
- Elimineer de beveiligingsrisico's van dataduplicatie: Het in bulk exporteren van CRM-data naar third-party vector databases omzeilt de native permissiemodellen, audit logs en access control policies van het systeem.
- Implementeer gerichte, geauditeerde connectors: Bouw scoped connectors die beperkt zijn tot specifieke query-typen en zorg ervoor dat system logs de onderliggende database-queries vastleggen naast de antwoorden van het model.
- Evalueer Self-Hosting realistisch: Private of on-premise deployments verschuiven de verantwoordelijkheid voor infrastructuurbeveiliging en patching volledig naar jouw team. Dit maakt enterprise vendor-contracten met zero-retention policies de meer praktische keuze voor de meeste bedrijven.
De echte architectuurbeslissing in een enterprise RAG-project is niet welk embedding-model je moet gebruiken of welke vector database je moet draaien. Het is de scope: bewust beslissen welke delen van je data überhaupt in een retrieval-laag thuishoren, en welke delen daar nooit in de buurt mogen komen. Neem die beslissing goed en de rest is implementatiedetail. Ga hier de mist in, en geen enkele hoeveelheid tuning lost op wat eigenlijk een ontwerpprobleem is, en geen performance-probleem.
Een legacy CRM is een goed systeem om dit concreet te maken, omdat het meestal beide soorten data naast elkaar bevat. De gestructureerde kern — contactvelden, deal stage, accountstatus — is een relationele database met een UI-laag erbovenop, en heeft helemaal geen RAG nodig. Maar de meeste CRMs bevatten naast die velden ook een tweede laag: vrije tekst. Deal notes, call summaries, support tickets, case history geschreven in iemands eigen woorden, op verschillende momenten, in verschillende toonaarden. Die laag heeft geen exacte sleutel waarop je kunt zoeken, en dat is de werkelijke, legitieme reden dat RAG überhaupt in de buurt van een CRM komt. Behandel het hele CRM als één retrieval-probleem, gestructureerde velden en vrije tekst samen, en de architectuur pakt op twee verschillende, dure manieren verkeerd uit.
Waar RAG echt voor bedoeld is
Retrieval-augmented generation betekent een model een zoekstap geven voordat het antwoordt: haal de meest relevante chunks aan content op uit een document store, gebaseerd op betekenis in plaats van exacte keywords, en geef die chunks als context aan het model. Het bewijst zijn waarde bij content waarbij het juiste antwoord elke keer dat iemand het vraagt anders geformuleerd is: beleidsdocumenten, SOPs, de hierboven beschreven vrije-tekstlaag, interne wiki's. Niemand formuleert dezelfde vraag twee keer op dezelfde manier, en een keyword-zoekopdracht mist de versie die niet jouw exacte woorden gebruikt. Semantische retrieval lost dat specifieke probleem op, en alleen dat probleem.
Dat is de hele use case voor RAG. Het is een goed antwoord op "vind de passage die waarschijnlijk relevant is." Het is geen goed antwoord op "wat is het actuele accountsaldo van deze klant," en de gestructureerde helft van een CRM bestaat volledig uit vragen die op die tweede lijken.
Waarom de live data van je CRM niet in een Vector Index thuishoort
Het instinct, zodra RAG in je vocabulaire zit, is om het op alles te richten, inclusief het CRM. Dit is waar het probleem met data-integriteit begint.
Een vector-index is een snapshot. Records worden geëmbed, opgeslagen en doorzocht op basis van die opgeslagen versie, niet de live versie. Elke re-index heeft een vertraging, hoe klein ook, en een semantische zoekopdracht geeft de beste match terug, niet de juiste.
Voor een beleidsdocument is "best passende match" een prima resultaat; de betekenis is meestal stabiel en het is de formulering die varieert. Voor een CRM-record is "best passende match" de compleet verkeerde garantie. Je wilt niet de beste semantische gok van het model naar de status van een dossier of de contractwaarde van een klant. Je wilt de daadwerkelijke, actuele waarde, opgehaald op het moment dat deze nodig is, of je wilt dat het systeem duidelijk aangeeft dat het deze niet heeft.
Dit is het deel dat in veel "koppel je LLM aan je CRM"-pitches wordt gemist: gestructureerde data met een exacte sleutel — een klant-ID, een telefoonnummer, een dossiernummer — heeft geen semantische zoekopdracht nodig. Het heeft een directe, live lookup nodig. RAG en gestructureerde retrieval lossen verschillende problemen op, en een CRM-record behandelen als een document dat semantisch doorzocht moet worden, is hoe een systeem vol zelfvertrouwen de mist in gaat met iets dat een simpele database-query elke keer correct had opgelost.
Een praktijkvoorbeeld: Hoe dit er correct gesplitst uitziet
We passen precies deze splitsing toe in een callcenter-workflow die we voor een langdurige klant hebben gebouwd. Twee heel verschillende soorten informatie voeden dezelfde agent, en ze worden op twee heel verschillende manieren opgehaald.
Standard operating procedures (SOPs) zijn echt RAG-terrein. Call-scenario's komen nooit twee keer op dezelfde manier geformuleerd binnen, de juiste SOP moet worden gevonden op basis van wat de situatie daadwerkelijk betekent, niet door te matchen op een vaste zin, en de onderliggende documenten veranderen langzaam genoeg dat een periodiek ververschte index een acceptabele afweging is. Dat is retrieval die doet waar het goed in is.
De accountgegevens en dossiergeschiedenis van de beller zijn een heel ander verhaal. Zodra een gesprek binnenkomt, zoekt het systeem de beller op basis van het telefoonnummer en haalt het actuele record direct live op uit het CRM, elke keer opnieuw. Niets van dat record is vooraf geïndexeerd of ergens geëmbed. Het is een gestructureerde, deterministische lookup in het bron-systeem, geen semantische zoekopdracht in een kopie ervan. Als het account tien minuten geleden is bijgewerkt, ziet de agent die update direct. Er is geen snapshot die achterloopt.
Zet die twee naast elkaar en dat patroon is het werkelijke antwoord op "hoe koppel je een LLM aan een legacy CRM": meestal niet, althans niet in de zin van RAG. Je geeft de agent een gerichte, scoped, live connector met het CRM voor exacte lookups, en je bewaart retrieval voor het ongestructureerde materiaal eromheen.
Waar "Legacy" het moeilijker maakt, en waar het echte risico ligt
Moderne CRM's hebben over het algemeen schone, goed gedocumenteerde APIs, dus een live, scoped lookup is eenvoudig te bouwen. Legacy-systemen zijn de plek waar dit echt lastig wordt, en waar de kortere weg van "exporteer gewoon alles naar een vector store" verleidelijk wordt. Het bouwen van een fatsoenlijke live connector voor een twintig jaar oud on-premise systeem zonder fatsoenlijke API is immers echt engineering-werk, terwijl het bulk-exporteren van een database-dump naar een index relatief eenvoudig is.
Die shortcut is precies de verkeerde, om twee verschillende redenen. Het probleem met data-integriteit is al besproken: de export veroudert zodra deze is gemaakt, en elke dag daarna werkt de agent met een steeds minder actueel beeld. Het tweede probleem is security, en dat is de ernstigste: een export in een vector store is een volledige kopie van je CRM-data, buiten de access controls, audit logging en het permissiemodel van het bronsysteem om. Je hebt geen LLM aan je CRM gekoppeld; je hebt je CRM gedupliceerd naar een nieuwe, meestal minder goed beveiligde, plek.
Het juiste antwoord, zelfs bij een echt legacy-systeem, is het bouwen van een gerichte interface: een connector die de specifieke lookups kan uitvoeren die een agent daadwerkelijk nodig heeft, live, tegen het echte systeem, met inachtneming van de access controls die dat systeem al afdwingt. Het is vooraf meer werk. Maar het creëert geen tweede kopie van je klantdata die je vervolgens apart moet beveiligen, bewaren en uiteindelijk weer moet verwijderen volgens een eigen schema.
Wat "Secure" hier daadwerkelijk moet betekenen
Een paar concrete zaken volgen uit het serieus nemen hiervan, specifiek voor CRM-koppelingen:
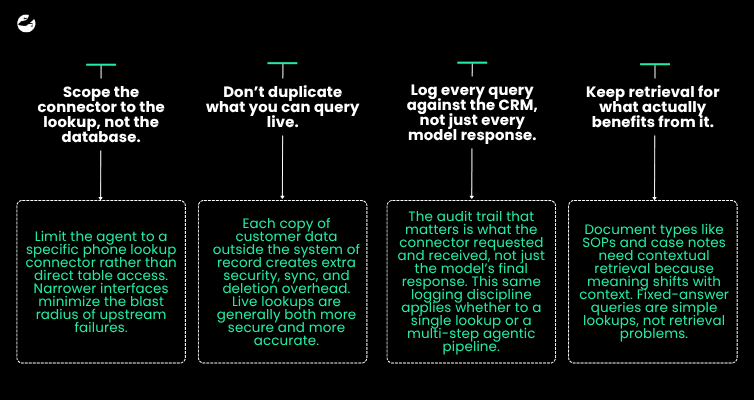
Beperk de scope van de connector tot de lookup, niet de database. Een agent die het record van een beller nodig heeft op basis van een telefoonnummer, moet een connector hebben die precies dat doet, en geen algemene query-toegang tot de onderliggende tabellen. Hoe gerichter de interface, hoe kleiner de impact (blast radius) als er stroomopwaarts iets misgaat.
Dupliceer niet wat je live kunt opvragen. Elke kopie van klantdata buiten het bronsysteem is iets nieuws dat beveiligd, up-to-date gehouden en uiteindelijk verwijderd moet worden. Als een live lookup mogelijk is, is dat meestal de veiligere optie, en niet alleen de meest nauwkeurige.
Log elke query op het CRM, niet alleen de antwoorden van het model. De audit trail die er hier toe doet, is wat de connector daadwerkelijk heeft opgevraagd en wat er is teruggekomen, niet alleen wat het model daarna heeft gezegd. Dit is dezelfde logging-discipline die we hebben beschreven voor agentic workflows in het algemeen, en het is net zo direct van toepassing op een enkele lookup als op een multi-step pipeline.
Bewaar retrieval voor wat er daadwerkelijk baat bij heeft. SOPs, beleidsdocumenten, dossiernotities; alles waarbij de betekenis meer varieert dan de onderliggende feiten. Als een query een exacte sleutel en één correct actueel antwoord heeft, is dat een lookup, geen retrieval-probleem, ongeacht hoe de vraag wordt geformuleerd wanneer deze op je roadmap belandt.
De eerlijke versie van "een LLM veilig koppelen aan je legacy CRM" gaat vooral over het weerstaan van de versie van het project die makkelijker klinkt: embed de database niet, maar bouw de connector.
De andere angst en de andere garantie
Alles hierboven gaat over architectuur: wat wordt opgehaald, hoe, en of er ergens een kopie van je data bestaat waar dat niet zou moeten. Er is een aparte angst die onder veel van deze gesprekken ligt en die architectuur alleen niet oplost. Het is de moeite waard om die ronduit te benoemen in plaats van eromheen te draaien: de zorg dat het model zelf leert van wat je ernaartoe stuurt. Dat het de vraag niet alleen beantwoordt en weer vergeet, maar het klantrecord ergens in zich opneemt, zoals een persoon iets zou onthouden wat je hem vertelt. Het is hetzelfde instinct dat ervoor zorgt dat je voorzichtig bent met wat je deelt op Facebook: een privacy policy is een belofte, en mensen hebben logischerwijs geleerd om meer te willen dan alleen een belofte.
Het is de moeite waard om nauwkeurig te zijn over deze vergelijking, en niet alleen begripvol. Het verdienmodel van een social platform is gebouwd op het gebruiken van wat je het geeft. Dat van een serieuze enterprise LLM-vendor is dat niet; jij bent de klant die betaalt voor gebruik, niet het product waarmee geld wordt verdiend, en dat verschil zie je terug in het contract, niet alleen in de marketing. Betrouwbare providers sluiten zakelijke en API-data expliciet uit van training, en enterprise-overeenkomsten kunnen daarbovenop een harde zero-retention optie bevatten. Dat is een echte garantie, ondersteund door een reële incentivestructuur, en die verdient het om serieus genomen te worden in plaats van afgedaan te worden als "slechts een beleidsregel."
But it is still a policy, and a CTO is entitled to want something stronger than a promise, however well-incentivised. That is what private or self-hosted deployment actually buys you: not a better contract, but no third party in the loop at all. The data never leaves infrastructure you control, on-premise or in your own cloud, and there is nothing left to train on because there is no outside vendor there to do it. This is not exotic engineering. A capable GPU, or even something as modest as a well-specced machine sitting in your own network, running an open model, is a realistic setup, not a moonshot.
Wat het echter niet is, is automatisch de veiligere keuze. Het is een andere verdeling van aansprakelijkheid, en de afweging pakt vaak anders uit dan hoe deze meestal wordt gepitcht. Een gerenommeerde vendor beschikt over de security-resources en draagt het juridische risico als hun infrastructuur wordt gecompromitteerd; die aansprakelijkheid is vastgelegd in de overeenkomst waarvoor je betaalt. Breng je het model volledig in-house, dan verschuift dat risico naar jou: jouw infrastructuur, jouw patching, en het vermogen van jouw team om iets te beveiligen waar een gespecialiseerde vendor op grote schaal voor is gebouwd. Self-hosting neemt risico niet zozeer weg, maar verplaatst het van een vendor wiens hele business afhangt van het goed doen hiervan, naar degene die jouw servers beheert.
We hebben nog geen private of self-hosted deployment voor een klant gebouwd. Niet omdat het technisch ingewikkeld is — dat is het echt niet — maar omdat voor de meeste bedrijven waarmee we werken de kosten voor het bouwen en onderhouden ervan niet in verhouding staan tot een risico dat een vendor met een goed contract al heeft afgedekt. Dat geldt niet voor elke klant, en voor echt gereguleerde data met een hard mandaat erachter is het een legitieme optie die de investering waard is. Het punt is dat het een bewuste beslissing moet zijn, genomen na het afwegen van wat het daadwerkelijk oplevert tegen wat het daadwerkelijk kost, en geen reflexmatige upgrade om een angst weg te nemen die een goed contract ook had kunnen oplossen.
Dus, in het kort:
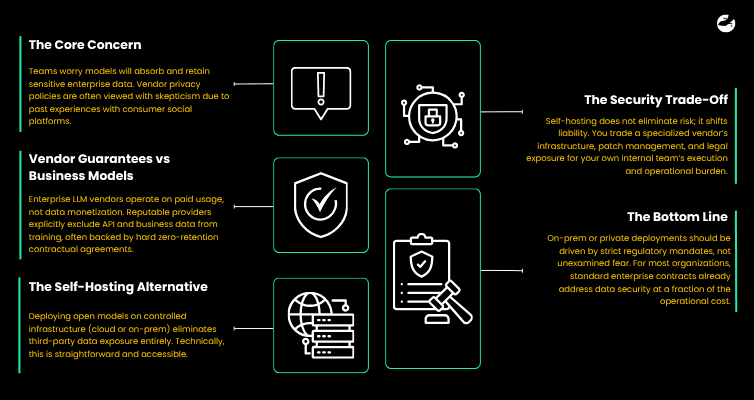
- De belangrijkste zorg: Teams zijn bang dat modellen gevoelige enterprise-data in zich opnemen en bewaren. Privacy policies van vendors worden vaak met scepsis bekeken door eerdere ervaringen met social platforms voor consumenten.
- Garanties van vendors vs. verdienmodellen: Enterprise LLM-vendors draaien op betaald gebruik, niet op het te gelde maken van data. Betrouwbare providers sluiten API- en zakelijke data expliciet uit van training, vaak ondersteund door harde contractuele zero-retention overeenkomsten.
- Het self-hosting alternatief: Het deployen van open modellen op gecontroleerde infrastructuur (cloud of on-premise) elimineert blootstelling van data aan derden volledig. Technisch gezien is dit eenvoudig en toegankelijk.
- De security-afweging: Self-hosting elimineert risico's niet; het verschuift de aansprakelijkheid. Je ruilt de infrastructuur, het patch-management en de juridische aansprakelijkheid van een gespecialiseerde vendor in voor de operationele last en uitvoering door je eigen interne team.
- De bottom line: On-premise of private deployments moeten worden gedreven door strikte regelgeving, niet door ongefundeerde angst. Voor de meeste organisaties dekken standaard enterprise-contracten de databeveiliging al af tegen een fractie van de operationele kosten.
Klaar om je visie om te zetten in custom software?
Het koppelen van LLMs aan legacy enterprise-systemen hoeft niet te betekenen dat je concessies doet aan databeveiliging of te maken krijgt met verouderde records. Als je een veilige live-lookup integratie wilt ontwerpen voor je legacy CRM, neem dan vandaag nog contact op met ons engineering-team om een architectuur-review in te plannen.
similar reads

Case Studies & Interviews
Lereng Tanah: Developing a Direct Booking Platform Malaysian Boutique Villa
29 January 2026

Case Studies & Interviews
Tactlink: How a Malaysian Entrepreneur Turned Networking Chaos into a Digital Community
22 January 2026

Software Development
Who Are the Top Software Development Vendors in Amsterdam for 2026?
26 August 2026
Vast tussen een goed idee en het juiste team om het te bouwen?Let's talk.
We werken met corporate innovation teams en ambitieuze scale-ups in Nederland, Singapore en Australië — en waar goede software nodig is. Stuur ons een bericht; we reageren binnen één werkdag.
Markus Monnikendam
Global Commercial Director
hello@lizard.global