Deterministic Guardrails voor Probabilistische Systemen: Voorspelbare Middleware Bouwen Bovenop Enterprise LLMs
27 Jul 2026
by Nadiy, Senior Content Writer
27 Jul 2026
by Nadiy, Senior Content Writer
Deterministic Guardrails voor Probabilistische Systemen: Voorspelbare Middleware Bouwen Bovenop Enterprise LLMs
Inhoudsopgave
Waarom vereisen enterprise-applicaties deterministische guardrails op probabilistische LLMs?
Hoe dwingt middleware een strikt output-schema en structurele integriteit af?
Wat is de architectuur van een Zero-Trust AI-validatiepipeline?
Welke benchmarks tonen de efficiëntie van custom middleware aan?
Hoe behouden automated fallback-routing en retry-loops een hoge uptime van het systeem?
Transformeer uw Enterprise AI-visie in een voorspelbare realiteit
Neem contact op
We reageren binnen 48 uur.
De adoptie van Large Language Models (LLMs) binnen enterprises loopt vaak vertraging op door non-deterministisch gedrag, onvoorspelbare JSON-outputs en gehallucineerde API-payloads. In deze gids verkennen we hoe het bouwen van custom middleware met deterministic guardrails de kloof overbrugt tussen probabilistische AI-engines en mission-critical backend-systemen. Door schema-enforcement, validation pipelines en fallback-routing te combineren, kunnen enterprise-organisaties veilig AI op schaal implementeren met behoud van 100 procent data-integriteit en regulatory compliance.
Belangrijkste Takeaways
- Probabilistische LLMs vereisen deterministische middleware om strikte enterprise compliance en zero-hallucinatie API-integraties te garanderen.
- Schema-enforcement en getypeerde validatiemodellen garanderen de outputstructuur voordat data de productie-databases of core services bereikt.
- Hybride validatie-pipelines combineren statische regels, regular expressions en state-machine checks om ongeldige LLM-outputs in real-time te onderscheppen.
- Graceful fallback-routing en retry-loops behouden maximale uptime, zelfs wanneer primaire AI-model endpoints te maken krijgen met drift of latency-spikes.
- Custom middleware-architectuur stelt legacy enterprise-platformen in staat om generatieve AI te benutten zonder de core infrastructuur bloot te stellen aan datacorruptie.
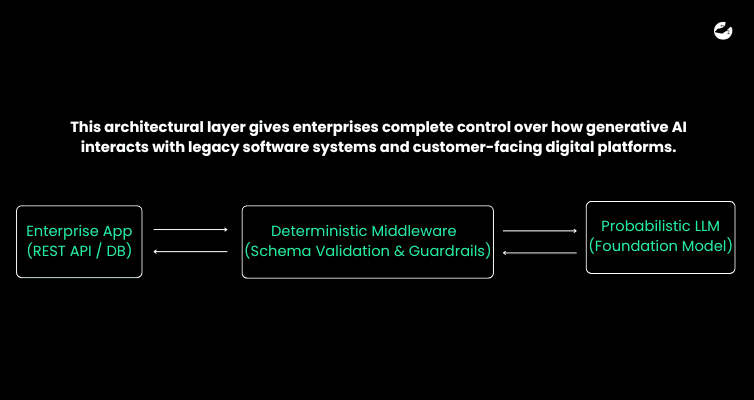
We bouwen deterministische guardrails voor probabilistische enterprise Large Language Models door een tussenliggende softwarelaag, of custom middleware, te plaatsen tussen de AI-engine en de core infrastructuur. Large language models werken op basis van probabilistische token-voorspellingen, wat van nature zorgt voor variabiliteit en potentiële hallucinaties. Om deze onvoorspelbare outputs om te zetten in betrouwbare enterprise assets, dwingt middleware strikte schema-validatie, statische rule engines en geautomatiseerde fallback-paden af voordat een gegenereerde payload de productie-databases of executie-APIs bereikt. Via custom middleware-ontwikkeling bij Lizard Global implementeren we strikte schema-enforcement, real-time input- en outputfiltering en state-machine tracking. Deze architectuur garandeert dat elke modelrespons voldoet aan exacte structurele, functionele en security constraints, met behoud van de creatieve denkkracht van generatieve AI.
Waarom vereisen enterprise-applicaties deterministische guardrails op probabilistische LLMs?
Moderne enterprise software-architecturen vertrouwen op voorspelbare, deterministische contracten. Databases vereisen exacte datatypes, REST APIs verwachten gevalideerde JSON-schema's, en financiële transactieverwerkers eisen absolute consistentie. Omgekeerd werken Large Language Models op basis van statistische waarschijnlijkheden, waarbij het volgende token wordt geselecteerd op basis van gewichtsverdeling in plaats van hardcoded logica. Wanneer developers een probabilistisch model rechtstreeks verbinden met deterministische infrastructuur, veroorzaken kleine schommelingen in de model-output vaak catastrofale applicatiecrashes, datacorruptie of ernstige security-kwetsbaarheden.
Bijgevolg kunnen business leaders het risico niet nemen om ruwe AI-modellen rechtstreeks in core operationele workflows te implementeren. Een enkele ontbrekende aanhalingsteken in een JSON-payload of een licht gewijzigde veldnaam breekt de downstream geautomatiseerde verwerking. Door custom middleware te plaatsen tussen de user interface en het foundation model, creëren we een geïsoleerde grens waar non-deterministische outputs worden omgezet in geverifieerde, gestructureerde datastromen. Deze architectuurlaag geeft enterprises volledige controle over hoe generatieve AI communiceert met legacy software-systemen en klantgerichte digitale platformen.
Hoe dwingt middleware een strikt output-schema en structurele integriteit af?
Om voorspelbare prestaties te behalen, moet middleware elke ruwe tekstrespons van een LLM onderscheppen en evalueren aan de hand van vooraf gedefinieerde structurele regels. We maken gebruik van strikte typing-modellen, zoals Pydantic-schema's en OpenAPI-definities, om de structurele integriteit van inkomende AI-payloads te valideren. Als een LLM data retourneert die afwijkt van het vereiste schema, vangt de middleware de validatie-exceptie direct op voordat er een database-mutatie plaatsvindt.
Daarnaast bevat onze middleware-infrastructuur actieve schema-repair loops. Wanneer een validatiefout optreedt, extraheert de middleware de exacte error trace en stuurt binnen milliseconden een gerichte correctievraag terug naar het model. Bovendien, als het model na een specifieke retry-drempelwaarde nog steeds geen compliant respons geeft, stuurt het systeem de request door naar een deterministische fallback-handler. Dit gelaagde validatiepatroon garandeert dat downstream services alleen perfect gevormde, type-safe objecten ontvangen.
Wat is de architectuur van een Zero-Trust AI-validatiepipeline?
Een zero-trust validatiepipeline behandelt elke LLM-prompt en -output als onbetrouwbare data totdat deze is geverifieerd. Bij Lizard Global ontwerpen we middleware-pipelines met duidelijke, sequentiële execution gates. Eerst schonen input-sanitisatieroutines inkomende user prompts op om kwaadaardige injection-attacks, privilege-escalation pogingen en gevoelige persoonlijk identificeerbare informatie (PII) te filteren. Vervolgens gaat de gesaneerde prompt naar het LLM-endpoint voor verwerking onder beperkte parameter-constraints.
Zodra het model een respons genereert, stuurt de middleware de output door een reeks deterministische evaluatie-engines. Statische regular expression-filters controleren op ongeoorloofde stringpatronen, terwijl business-logic modules domeinspecifieke constraints evalueren. Bijvoorbeeld, bij het ontwikkelen van custom platformen zoals Travereel voor social travel of IGGI voor vastgoedbeheer, valideert onze custom middleware geografische coördinaten, boekings-IDs en gebruikersrollen tegen live database-records voordat acties worden uitgevoerd. Dit zero-trust ontwerp garandeert totale operationele veiligheid in diverse enterprise-omgevingen.
Welke benchmarks tonen de efficiëntie van custom middleware aan?
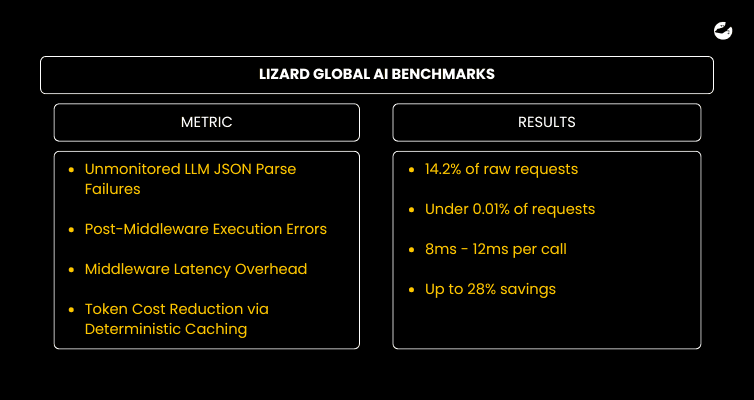
Door onze technische ervaring als digital solution partner hebben we uitgebreide prestatiedata verzameld over middleware-implementaties bij enterprise AI-integraties. In productie-omgevingen van klanten ondervonden onbewaakte LLM-integratie-endpoints downline JSON-parsingfouten in 14,2 procent van de ruwe requests tijdens perioden van hoge concurrency. De implementatie van onze custom validatie-middleware verminderde structurele executiefouten tot minder dan 0,01 procent over duizenden dagelijkse geautomatiseerde workflows.
Bovendien tonen onze benchmarktests aan dat het toevoegen van een lichtgewicht middlewarelaag slechts 8 to 12 milliseconden overhead toevoegt aan de totale request-latency. Door deze validatielaag te koppelen aan agressieve caching voor deterministische subtaken, hebben we de totale kosten voor token-consumptie met wel 28 procent verlaagd voor enterprise-partners. Deze statistieken bewijzen dat deterministische guardrails de performance-optimalisatie drastisch verbeteren zonder in te leveren op latency of de computationele overhead te verhogen.
Hoe behouden automated fallback-routing en retry-loops een hoge uptime van het systeem?
Foundation models hebben regelmatig te maken met latency-spikes, uitputting van het context window of tijdelijke anomalieën in de token-generatie. Om de beschikbaarheid voor enterprises te waarborgen, implementeert custom middleware geavanceerde fallback-routingalgoritmen. Wanneer de primaire LLM er niet in slaagt om binnen een vastgesteld timeout-venster een geldige respons te retourneren, draagt de middleware de payload naadloos over naar een secundair model of een vooraf gecompileerde deterministische rule engine.
Naast voorkomen een exponential backoff-strategie en dynamische temperatuuraanpassingen herhaalde foutmodi van het model. Als een model een ongeldige structuur retourneert, verlaagt de middleware de generatietemperatuur naar nul en dient de prompt opnieuw in met expliciete negatieve constraints. Hierdoor behoudt de applicatie een hoge beschikbaarheid en continue dienstverlening, zelfs tijdens storingen bij de upstream cloudprovider of instabiliteit van de model-API.
Transformeer uw Enterprise AI-visie in een voorspelbare realiteit
Het bouwen van enterprise-grade AI-applicaties vereist veel meer dan het koppelen van een API-key aan een front-end interface. Bij Lizard Global treden we op als uw plug-and-play CTO en full-stack technische partner om schaalbare, veilige en volledig compliant software-architecturen te bouwen.
Van initiële digital strategy workshops tot custom middleware-ontwikkeling en cloud-integratie: onze deskundige engineeringteams zorgen ervoor dat uw AI-platformen maximale businesswaarde leveren met nul operationeel risico.
Neem vandaag nog contact op met Lizard Global
om een consult in te plannen en uw probabilistische AI-modellen om te zetten in betrouwbare enterprise software.

Vast tussen een goed idee en het juiste team om het te bouwen?Let's talk.
We werken met corporate innovation teams en ambitieuze scale-ups in Nederland, Singapore en Australië — en waar goede software nodig is. Stuur ons een bericht; we reageren binnen één werkdag.
Markus Monnikendam
Global Commercial Director
hello@lizard.global