Het verborgen data-readiness-werk dat bepaalt of je AI-integratie slaagt
07 Sep 2026
by Nadiy, Senior Content Writer
07 Sep 2026
by Nadiy, Senior Content Writer
Het verborgen data-readiness-werk dat bepaalt of je AI-integratie slaagt
Inhoudsopgave
Hoe saboteren datasilo's en onvolledige records enterprise AI?
Wat is er nodig om een AI-ready unified data-architectuur te bouwen?
Waarom is context engineering crucialer dan prompt engineering?
Hoe voorkomt strikte data governance AI-beveiligingsrisico's en technische schuld?
Waarom zouden enterprises kiezen voor full-stack development experts zoals Lizard Global voor AI-integratie?
Transformeer vandaag nog je enterprise data-fundament met Lizard Global
Neem contact op
We reageren binnen 48 uur.
De meeste enterprise AI-projecten mislukken niet door zwakke algoritmen of slechte prompts; ze mislukken omdat de onderliggende data ongeorganiseerd, ontoegankelijk of onvolledig is. Sector-benchmarks tonen aan dat tot wel 80% van de enterprise AI-initiatieven wordt gestaakt of geen meetbare return on investment oplevert vanwege een gebrekkige data-readiness. Om generatieve AI-tools, voorspellende platformen of geautomatiseerde workflows te bouwen die echt waarde leveren, moeten organisaties eerst hun data-fundament opschonen, structureren en beheren. Bij Lizard Global hebben we klanten begeleid door complexe digitale transformaties door prioriteit te geven aan robuuste datapipelines en een naadloze systeemarchitectuur. In deze gids onthullen we de vijf onmisbare data-readiness-fasen die elke enterprise moet doorlopen alvorens kunstmatige intelligentie op te schalen, waarbij we inzichten delen uit onze praktijkervaring in engineering binnen de logistiek, fintech en digitale gezondheidszorg.
Belangrijkste takeaways
- Enterprise AI-modellen weerspiegelen de kwaliteit van hun onderliggende data; ongeorganiseerde of gesiloode data veroorzaakt hallucinaties, onnauwkeurige outputs en het mislukken van projecten.
- Gartner voorspelt dat organisaties tot en met 2026 60% van de AI-initiatieven zullen staken die een goede, AI-ready data-infrastructuur missen.
- Het bouwen van custom API-middleware, unified data lakes en continue transformatielagen is essentieel om legacy-systemen te verbinden met moderne AI-agents.
- Context engineering en strikte data governance voorkomen de verspreiding van technische schuld (technical debt) en garanderen strikte compliance met beveiligingsprotocollen.
- Samenwerken met een full-stack digital solution expert zoals Lizard Global zorgt ervoor dat je data engineering, UI/UX en AI-architectuur op één lijn liggen voor een meetbare business ROI.
Om een AI-integratie te implementeren die daadwerkelijk werkt, moeten we de onderliggende datapipelines herstellen voordat we complexe algoritmen schrijven of UI-componenten bouwen. De meeste enterprises springen direct naar modelselectie en prompt engineering, om er vervolgens achter te komen dat hun AI-projecten vastlopen of mislukken omdat hun interne data gefragmenteerd is, vastzit in legacy-software, of vol met ontbrekende velden zit.
Bij Lizard Global hebben we aan den lijve ondervonden dat een succesvolle enterprise AI-implementatie leunt op gestructureerde data engineering, context-optimalisatie en veilige API-integraties. Uit sectoronderzoek blijkt consistent dat tot wel 80% van de mislukte AI-projecten voortkomt uit slechte datakwaliteit in plaats van een slechte modelarchitectuur. Sterker nog, Gartner voorspelt dat organisaties tot en met 2026 60% van de AI-initiatieven zullen staken die een goede, AI-ready data missen. Als we willen dat onze machine learning-modellen en generatieve AI-agents nauwkeurige inzichten opleveren, moeten we eerst het minder glamoureuze datavoorbereidingswerk uitvoeren.
Hoe saboteren datasilo's en onvolledige records enterprise AI?
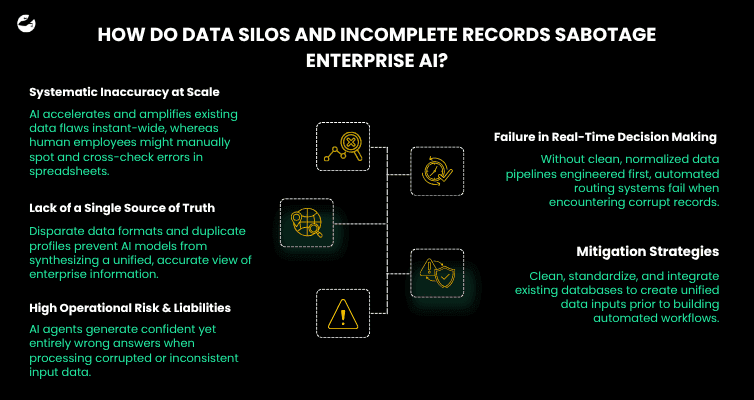
Wanneer we AI-modellen koppelen aan niet-opgeschoonde enterprise-systemen, veranderen ontbrekende records en uiteenlopende formaten veelbelovende automatiseringspilots in operationele risico's. Als vijftien procent van onze klantprofielen historische transactiegegevens mist, zal elke AI-agent die op die data vertrouwt om klantbenadering te personaliseren, in vijftien procent van de gevallen falen. Enterprise-data leeft meestal verspreid over geïsoleerde platformen zoals Salesforce, SAP, custom interne databases en API's van derden. Wanneer deze systemen verschillende talen spreken of dubbele profielen opslaan, kan het AI-model geen single source of truth vaststellen.
Het grootste gevaar hier is dat kunstmatige intelligentie bestaande datafouten op grote schaal versterkt. Waar menselijke medewerkers handmatig spreadsheets controleren om datafouten op te sporen, verwerkt een geautomatiseerde AI-agent diezelfde fouten direct, wat leidt tot zelfverzekerde maar volstrekt onjuiste antwoorden. Dit voorkomen we door geautomatiseerde datavalidatie-gates in te richten en bestaande databases op te schonen voordat we inference-modellen uitrollen.
Bij het werken met klanten in de transport- en logistieksector, zoals onze samenwerking met DEXTR om realtime dispatching en ritopties te stroomlijnen, hebben we te maken met enorme hoeveelheden realtime trackingdata en operationele records. Voordat we naadloze trackingtools en slimme dispatch-functies kunnen bouwen, moeten er schone datapipelines worden ontworpen om locatie-inputs, transactiestatuscodes en chauffeurslogboeken binnen het operationele ecosysteem te normaliseren. Door deze data-inputs eerst te standaardiseren, kunnen geautomatiseerde systemen operaties nauwkeurig routeren en statussen updaten zonder te falen door beschadigde records.
Wat is er nodig om een AI-ready unified data-architectuur te bouwen?
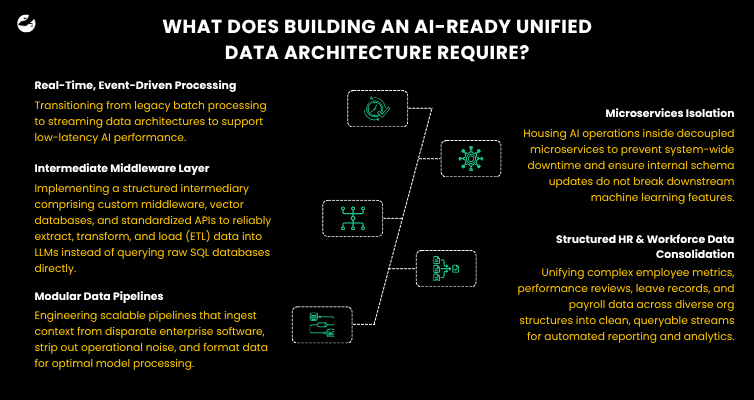
Het creëren van een AI-ready omgeving vereist een verschuiving van statische batchverwerking naar realtime, event-driven data-architecturen. We kunnen niet simpelweg ruwe SQL-databases in een Large Language Model dumpen en betrouwbare prestaties verwachten. In plaats daarvan moeten we een tussenlaag bouwen van custom middleware, vector-databases en gestandaardiseerde API's die schone data extraheren, transformeren en laden (ETL) in de AI-verwerkingsomgeving.
Dit architectonische fundament leunt op modulaire datapipelines die context extraheren uit uiteenlopende enterprise-software, ruis wegfilteren en de data zo formatteren dat het model deze efficiënt kan verwerken. Door je AI-operaties te isoleren binnen gestructureerde microservices, voorkomen we systeembrede downtime en zorgen we ervoor dat schema-updates in de ene interne applicatie de downstream machine learning-functies niet verstoren.
We hebben exact deze architectonische aanpak toegepast bij het ontwikkelen van workforce-oplossingen zoals Talent Portal en systemen voor het matchen van medewerkers zoals GetHired. Moderne HR-managementplatformen moeten complexe medewerkersstatistieken, prestatiebeoordelingen, verlofregistratie en salarisgegevens over diverse organisatiestructuren heen consolideren. Door robuuste backend-datapipelines te ontwerpen die ruwe HR-metrics structureren in schone, opvraagbare datastromen, kunnen platformen naadloos nauwkeurige analyses en geautomatiseerde rapportages genereren, waardoor managers bruikbare inzichten krijgen zonder data-discrepanties.
Waarom is context engineering crucialer dan prompt engineering?
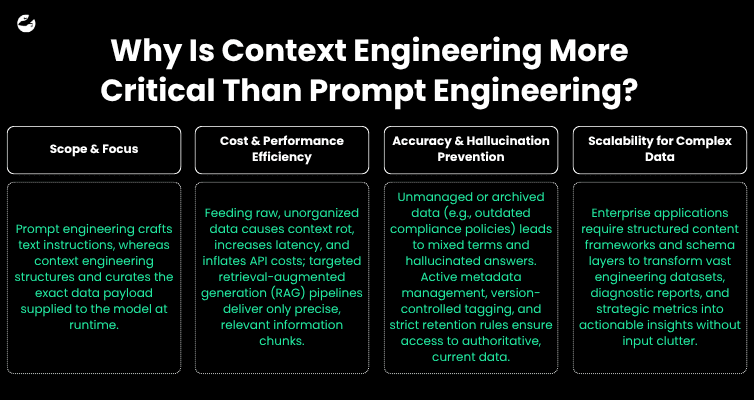
Terwijl prompt engineering zich richt op het opstellen van betere instructies voor een AI-chatbot, structureert context engineering de exacte, relevante payload aan data die tijdens runtime aan het model wordt gevoed. Een AI-model voorzien van te veel ruwe, ongeorganiseerde informatie leidt tot context-rot, hoge latentie (latency) en hogere API-kosten. We moeten retrieval-augmented generation (RAG)-pipelines bouwen die alleen de meest nauwkeurige, actuele stukjes informatie ophalen die relevant zijn voor het specifieke verzoek van de gebruiker.
Context engineering betekent ook het opzetten van actief metadata-management om te voorkomen dat verouderde documenten je output vervuilen. Als een AI-retrievalsysteem een gearchiveerd compliance-beleid van drie jaar geleden ophaalt naast het huidige beleid, zal het termen door elkaar halen en onjuiste antwoorden hallucineren. We implementeren versiebeheerde metadata-tagging en duidelijke bewaarregels, zodat het model altijd toegang heeft tot actuele, gezaghebbende data.
Tijdens ons werk met complexe analysetools, zoals de ontwikkeling van het AI-gestuurde inspectieplatform Parexus, was context-nauwkeurigheid essentieel. Het verwerken van enorme hoeveelheden complexe engineeringdata, diagnostische rapporten en strategische metrics vereist gestructureerde content-frameworks en intuïtieve workflows voor dataverwerking. Door ruw onderzoek te organiseren in goed gedefinieerde schemalagen, worden complexe datasets direct toegankelijk en begrijpelijk voor zakelijke besluitvormers, wat de verwarring door onoverzichtelijke of verouderde inputs wegneemt.
Hoe voorkomt strikte data governance AI-beveiligingsrisico's en technische schuld?
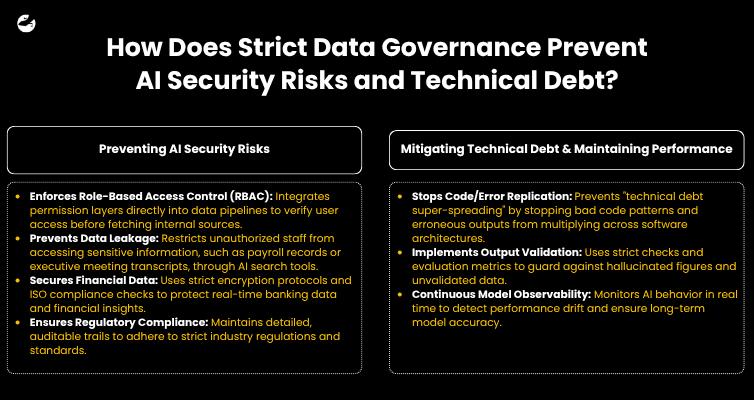
Het integreren van AI-tools in enterprise-workflows brengt specifieke beveiligingsrisico's met zich mee, waaronder datalekken, ongeautoriseerde toegang tot gevoelige gegevens en het niet naleven van regelgeving. Zonder role-based access control die rechtstreeks in je datapipeline is ingebouwd, kan een AI-zoektool per ongeluk gevoelige salarisgegevens of notulen van directievergaderingen onthullen aan onbevoegd personeel. We bouwen granulaire governance-lagen die gebruikersrechten verifiëren voordat er interne databronnen worden opgehaald.
Bovendien zorgen onbeheerde AI-integraties voor een snelle verspreiding van technische schuld (technical debt), waarbij slechte codepatronen of foutieve outputs automatisch worden gereproduceerd in je software-architectuur. We voorkomen dat deze schuld zich opstapelt door evaluatiemetrics, model observability-tools en strikte output-validatiecontroles te implementeren.
Deze guardrails monitoren continu het modelgedrag om prestatieverloop (performance drift) te detecteren, te waken tegen gehallucineerde cijfers en auditeerbare sporen bij te houden voor regulatory compliance.
We gaven prioriteit aan deze strenge beveiligings- en governance-standaarden bij het bouwen van platformen in de FinTech-sector zoals ViroPay en realtime transactie-apps zoals GWAP. Het verwerken van realtime financiële data en gevoelige bankinformatie laat nul ruimte voor beveiligingsfouten of ongevalideerde dataverwerking. We ontwikkelen strikte encryptieprotocollen, ISO-compliance-checks en nauwkeurige toegangsmachtigingslagen om gebruikersdata te beschermen. Dit zorgt ervoor dat geautomatiseerde financiële inzichten nauwkeurig, veilig en in overeenstemming met de regelgeving van de financiële sector blijven.
Waarom zouden enterprises kiezen voor full-stack development experts zoals Lizard Global voor AI-integratie?
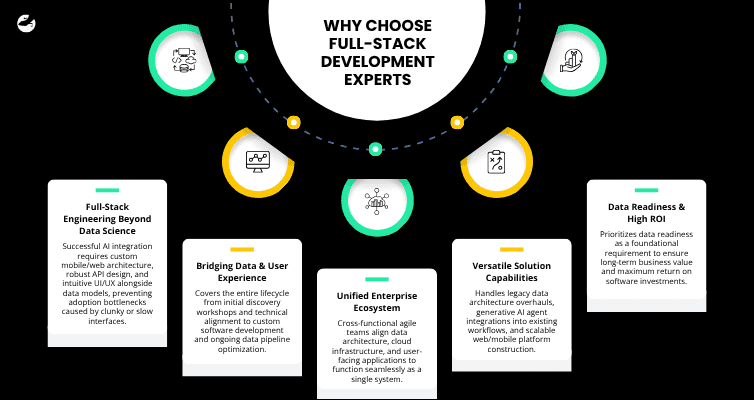
Een succesvolle AI-implementatie is nooit alleen een data science-project; het is een full-stack engineering-uitdaging die vraagt om een custom mobiele en webarchitectuur, naadloos API-design en intuïtieve UI/UX-workflows. Als je AI-backend intelligente voorspellingen genereert, maar je frontend-interface is onhandig of traag, zullen je interne teams of eindklanten weigeren de technologie te adopteren.
Bij Lizard Global overbruggen we de kloof tussen complexe datavoorbereiding en user experience design. We werken samen met enterprises vanaf de eerste discovery workshops en technische afstemming tot aan custom software development en voortdurende optimalisatie van de datapipeline. Onze cross-functional agile teams zorgen ervoor dat je onderliggende data-architectuur, cloudinfrastructuur en gebruikersgerichte applicaties samenwerken als één enterprise-ecosysteem.
Of je nu legacy data-architecturen moet herzien, generatieve AI-agents in bestaande workflows wilt integreren of schaalbare web- en mobiele platformen wilt bouwen, onze software development-experts brengen bewezen technische expertise naar elk project. We behandelen data-readiness als een essentieel fundament, zodat je software-investeringen op de lange termijn bedrijfswaarde en een hoge return on investment (ROI) opleveren.
Transformeer vandaag nog je enterprise data-fundament met Lizard Global
Het bouwen van een AI-integratie die schaalt, vereist dat we voorbijgaan aan oppervlakkige demo's en ons focussen op de kern van de software-infrastructuur die intelligente enterprise-systemen aandrijft. Als jouw organisatie klaar is om haar datapipelines op te schonen, schaalbare AI-mogelijkheden te integreren en hoogwaardige custom applicaties te lanceren, is Lizard Global jouw end-to-end technische partner.
We werken samen met vooruitstrevende enterprises om digitale producten te ontwerpen, te ontwikkelen en te implementeren die complexe zakelijke uitdagingen oplossen. Neem contact op met Lizard Global vandaag nog om te sparren met onze software-architecten en te beginnen met het bouwen van je AI-ready data-fundament.
similar reads

Case Studies & Interviews
Lereng Tanah: Developing a Direct Booking Platform Malaysian Boutique Villa
29 January 2026

Case Studies & Interviews
Tactlink: How a Malaysian Entrepreneur Turned Networking Chaos into a Digital Community
22 January 2026

Software Development
Who Are the Top Software Development Vendors in Amsterdam for 2026?
26 August 2026
Vast tussen een goed idee en het juiste team om het te bouwen?Let's talk.
We werken met corporate innovation teams en ambitieuze scale-ups in Nederland, Singapore en Australië — en waar goede software nodig is. Stuur ons een bericht; we reageren binnen één werkdag.
Markus Monnikendam
Global Commercial Director
hello@lizard.global